| 档案高质量数据集到底是什么 |
| —云典智能科技的一点思考(配图版) |
| 发布日期:2026-11-04 来源:武汉云典智能科技有限公司 作者:办公室 浏览次数:1726 字体: 小 中 大 |
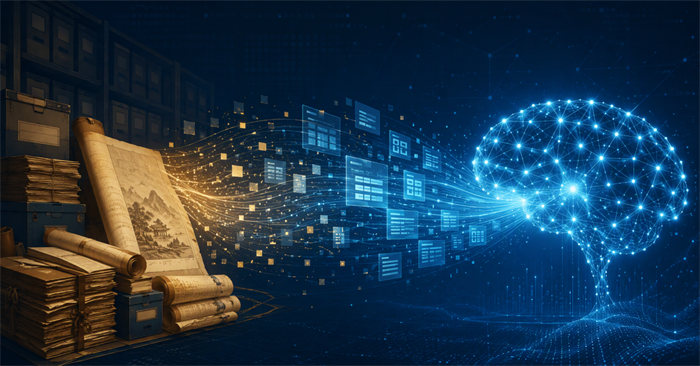
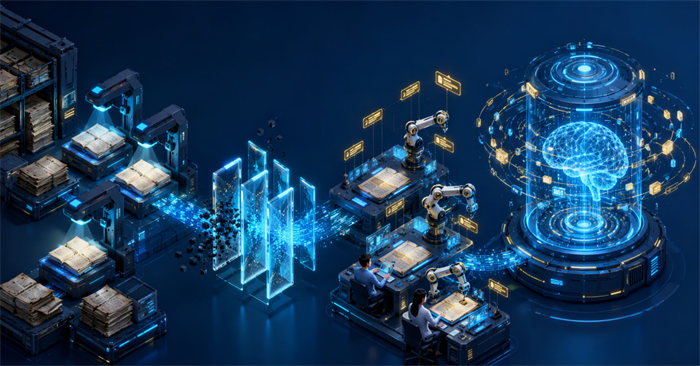
档案资源经数据化加工流向AI神经网络 最近一年多,“高质量数据集”这个词在档案行业里出现的频率越来越高。国家层面出台了《高质量数据集建设指南》《国家数据基础设施建设指引》等文件,2026 年全国档案局长馆长会议也明确提出,要稳妥运用人工智能、大数据等新技术,持续提升档案治理效能。 但说实话,跟不少档案馆的老师交流下来,我们发现一个挺普遍的现象:很多单位手里明明有丰富的馆藏资源,也完成了相当规模的数字化加工,可一旦问到”你们的档案高质量数据集建得怎么样了”,大家往往是两种反应——要么觉得”我们的档案数据库都建好多年了,不就是数据集吗”,要么觉得”听说过,但不知道具体该做成什么样”。 作为一家长期关注档案数字化与数据智能的公司,云典智能科技在这条业务线上也投入了不少精力。这篇文章,我们就把”档案高质量数据集”这件事从头讲清楚:它是什么、和档案数据库有什么区别、为什么要建、怎么建,最后再给大家看几个现成的例子,让大家直观感受一下”一个能用的数据集到底长什么样”。 一、先下定义:什么是档案高质量数据集 所谓高质量数据集,是指经过规范化采集、清洗加工,可以直接用于 AI 模型开发训练、能够有效提升模型输出效果的数据集合,普遍具备高应用价值、高知识密度、高技术门槛几个特点。 档案高质量数据集是其中的细分类型,就是以档案资源为原始素材加工形成的 AI 可用数据集。
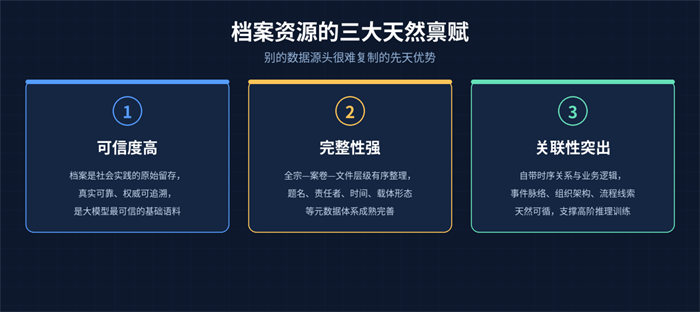
档案的三大禀赋 它既继承了通用高质量数据集的共性,又因为档案这种载体的特殊性,形成了三个非常突出的禀赋: 一是可信度高。 档案是社会实践的原始留存,真实可靠、权威可追溯。在大模型训练语料鱼龙混杂、中文优质语料占比偏低的背景下,档案天然就是可信度最强的基础语料之一。 二是完整性强。 普通业务数据、网络爬取的数据往往七零八落,而档案长期以来按照”全宗—案卷—文件”的层级有序整理,配套有题名、责任者、形成时间、载体形态、开放状态等一整套成熟的元数据描述体系。这套体系方便对样本做层级化组织和多维度特征提取,是别的数据源头很难复制的优势。 三是关联性突出。 档案自带清晰的时序关系和内在业务逻辑,一份文件为什么产生、经过谁的手、办了什么事,这些语义线索是天然存在的。这对 AI 理解事件脉络、组织运行规则,支撑因果推理、类比推理这类高阶能力训练,价值极大。 二、一个关键误区:档案数据库 ≠ 档案高质量数据集 这是我们在交流中碰到的最多、也最要命的一个误解。
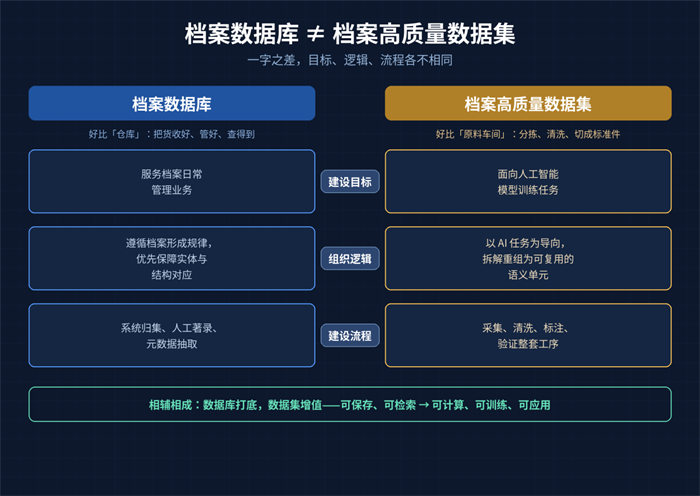
仓库与原料车间之喻 档案数据库,是档案管理单位围绕保管利用需求,把档案实体信息、管理信息、运行环境信息按照既定数据模型组织起来的数据集合。两者定位并不等同: 从建设目标看:档案数据库服务于档案日常管理业务;高质量档案数据集面向的是人工智能模型训练任务。 从组织逻辑看:档案数据库遵循档案形成规律,优先保障实体与结构的对应关系;高质量数据集以 AI 任务为导向,要对档案内容重新拆解组合,形成可复用的语义单元。 从建设流程看:档案数据库依靠系统归集、人工著录、元数据抽取就能搭起来;高质量数据集则要完整经历采集、清洗、标注、验证一整套工序。 打个比方:档案数据库是”仓库”,把货收好、管好、查得到;档案高质量数据集是”原料车间”,要按生产线的要求把原料分拣、清洗、切成标准件。仓库管理得再好,原料不经过这道车间工序,生产线(大模型)是用不起来的。
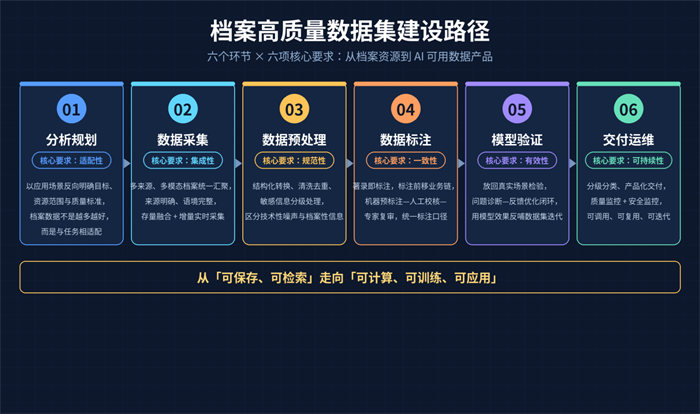
档案数据库与档案高质量数据集对比 当然,二者是相辅相成的:档案数据库是数据集的基础数据源,前期数字化、著录、粗清洗的成果,为后续的语义标注、特征提取、结构转换打底;而高质量数据集,是档案资源从”可保存、可检索”走向”可计算、可训练、可应用”的深度价值升级。 三、为什么要建:三重现实意义 第一,响应国家战略,给大模型供好料。 训练语料直接决定 AI 模型的价值取向。长期以来主流大模型的训练语料中英文占比极高,中文优质资源占比偏低,导致模型面对我国的历史文化、制度理念时容易产生认知偏差。档案根植于国家治理与公共服务体系,自带鲜明的制度属性,记录的是经过规范留存的真实事件与组织行为。打造高质量档案数据集,可以在优化模型能力的同时,帮助校正 AI 在复杂社会场景下的判断偏差。与此同时,随着 AI 向各行业落地,行业专属高质量数据集的缺口越来越大——专业档案、科技档案业务逻辑连贯、领域知识富集,是打造行业数据集的上好原料,浙江省疾控中心的电子疾病档案(EDR)数据集已经验证了这条路走得通。 第二,激活档案资源价值,融入数据要素市场。 建设档案数据集,本质上是重塑档案资源的组织逻辑和利用模式,让档案以结构化、语义化、标准化的形态接入智能化应用,变成可计算、可调用、可合规流通的数据要素。苏州丝绸纹样数据集就是一个标杆:项目汇聚了 222 件珍贵文物、7012 份近现代丝绸样本档案高清资源,形成 3 个子数据集,依托市场化授权机制面向纺织、游戏、汽车、美妆等行业开放,累计授权 31 批次。档案就这样从”锁在库房里”变成了”养在产业里”。 第三,反哺档案自身业务,推动”AI+档案”落地。 不少档案馆已经在尝试把 AI 用到档案鉴定、开放审核等环节,但普遍缺少高质量标注语料支撑,模型训练效果不稳定。原因不难理解:巧妇难为无米之炊。比如开放审核这个场景,只有对涉密内容、个人隐私、敏感字段做了精细化标注,形成了体系化的风险样本库,模型才可能学会自主识别、精准研判。数据集建设,是把人工智能真正嵌进档案全流程业务的先决条件。 四、怎么建:六个环节、六项要求 《高质量数据集建设指南》提出了六个建设环节,《国家数据基础设施建设指引》强调向流通利用延伸。两相结合,我们把它概括为一条”场景牵引”的主线:
六环节建设路径 1. 分析规划——要求适配性。 不能抱着”有什么档案就加工什么数据集”的思路,而要以具体应用场景反向明确目标、资源范围、加工方式和质量标准。先做三件事:剖析数据需求(应用场景对规模、模态、内容、标注精度、更新频率的要求),界定建设边界(数据集需要稳定的样本边界与版本状态,保障结果可复现),盘点资源(明确开放状态、访问权限、脱敏规则、利用边界和风险处置机制)。这里有一个关键判断:档案数据并非越多越好、越全越好,而应与目标任务相适配,这决定了后续所有环节的成本与质量上限。 2. 数据采集——要求集成性。 核心是把分散在不同系统、不同载体、不同管理层级的档案资源,转化为来源明确、语境完整的基础数据资源。存量方面,要解决多源异构数据融合的问题,统一接入调度;增量方面,要建立实时或周期性的采集机制,推动增量采集与电子文件归档衔接,让前端收集齐全、要素合规、来源可靠。 3. 数据预处理——要求规范性。 三件事:结构化转换(借鉴档案数字化经验,让档案从”文件级副本”走向”可处理文本”);清洗去重(修复 OCR 识别错误、字段缺失、时间格式不一、目录全文不匹配等问题,特别要区分”技术性噪声”与”档案性信息”——批注、修改痕迹往往有凭证意义,不能一洗了之);敏感信息处理(脱敏不宜一删了之,应建立识别机制与分级处理机制,保留可审计的处理记录)。 4. 数据标注——要求一致性。 传统标注是采集完成后的”事后加工”,容易造成语境脱节、语义失真。档案领域的正确解法是把标注嵌入文档管理全流程,“著录即标注”,让标注前移到业务链:文件形成环节标注核心内容对象与业务语境,文件流转环节从办理意见、审批意见中提取关键行为与证据片段,归档鉴定环节标注事由标识与文件功能角色,提供利用环节把真实需求转化为数据集优化线索。在此之上,再面向具体场景做高级标注(问答对、实体关系、风险类别与触发条件),形成可直接用于模型训练的精细化数据。组织实施上,建议走”机器预标注—人工校核—专家复审”的半自动路径,并建立统一标注规范与质量控制。 5. 模型验证——要求有效性。 把数据集放回真实场景检验:围绕目标场景设置基准任务与评价指标,测试结构识别、术语抽取、风险判定等能力。效果不达预期,就启动”问题诊断—反馈优化”闭环:召回率低就补数据来源,误报率高就优化标签体系,预测误差大就补时效性——用模型效果反哺数据集迭代。 6. 交付运维——要求可持续性。 分级分类管理与产品化交付,明确合法合规、风险导向、动态调整、可操作的原则;建立质量监控、系统监控、安全监控和服务保障机制,让数据集成为可调用、可复用、可迭代的长期数据产品,而不是一次性工程。 一句话总结:档案数据要从”可保存、可检索”走向”可计算、可训练、可应用”,前提必须是可用、可信、可控。
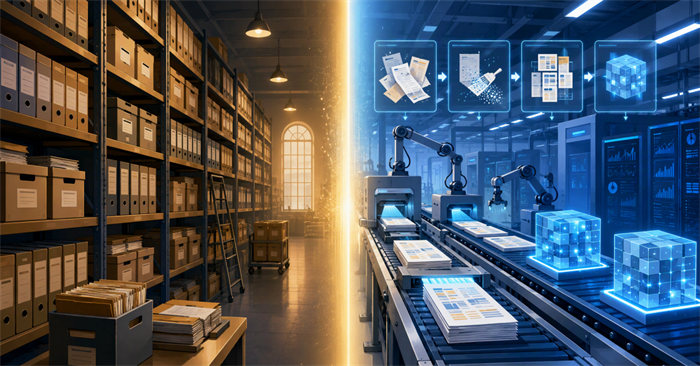
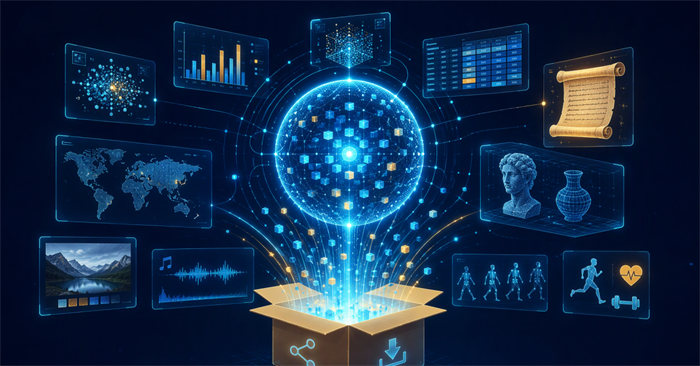
档案数据加工流水线示意 五、一个高质量数据集到底长什么样?看这几个例子 概念讲再多,不如看实物。很多老师困惑”数据集到底做成什么样才算数”,我们特意从开源社区找了几个有代表性的高质量数据集,它们虽然不属于档案行业,但每一个都体现了”AI 就绪数据”的共同标准:来源明确、结构统一、带元数据、有许可说明、可直接下载训练。档案数据集的交付形态,完全可以参照它们来做。
开源数据集生态 1. 中华古诗词数据集(chinese-poetry) 最全的中华古典文集数据库:5.5 万首唐诗、26 万首宋诗、2.1 万首宋词,涵盖唐宋两朝近 1.4 万诗人、两宋 1.5 千词人,54k+ Star。数据全部以 JSON 格式存储,程序可以直接做结构化处理——这就好比我们的档案数据要能提供带标准字段的结构化文本,而不是一摞扫完就完事的 PDF。 开源地址:https://github.com/chinese-poetry/chinese-poetry 2. 3D 模型数据集(scenario-labs/3d-collection) HuggingFace 上的大规模 3D 模型数据集,1342 条样本统一采用 OpenUSD 格式,每条记录都带 image、workflow、model、prompt 等标准字段,网页上可以直接浏览、检索,也可以通过 API 批量调用。它示范的是”统一格式 + 标准字段 + 在线可查”的数据集组织方式。 数据地址:https://huggingface.co/datasets/scenario-labs/3d-collection 3. 雅思词库”词光”(word-atlas) 7298 个单词和例句、7298 幅原创插画、两万多段英美音朗读音频,代码 MIT 协议、数据 CC BY 4.0 协议,权责一目了然。它给档案数据集的启示在于:许可协议和权责说明是数据集产品化流通的前提,苏州丝绸纹样数据集的授权运营也是同一逻辑。 开源地址:https://github.com/designfuchen/word-atlas 4. 健身动作数据集(exercises-dataset) 1324 个健身动作,每个动作都配齐缩略图、GIF 动画、分类、目标肌群和分步讲解,MIT 协议。把”一个动作”类比成”一份档案文件”——单条样本自带完整的元数据和关联资源,这就是档案著录体系天然具备、稍加加工就能兑现的优势。 开源地址:https://github.com/hasaneyldrm/exercises-dataset 5. 全球行政区划数据集(countries-states-cities-database) 覆盖 250 个国家和地区、5299 个州省、15 万多个城市,以社区协作方式持续维护,版本号、更新日期、许可协议(ODbL 1.0)全部公开。档案数据集同样需要这种版本状态和更新机制,否则模型训练结果无法复现,数据集本身也无法持续运营。 开源地址:https://github.com/dr5hn/countries-states-cities-database 6. 物理模拟数据集(The Well) 15TB 规模,包含 16 组物理模拟数据,覆盖生物系统、流体动力学、声学散射等方向,数据以统一网格、固定时间间隔采样,存储为自描述 HDF5 文件并配元数据 YAML 文件,还有配套论文(NeurIPS 2024)和基准测试体系。它是”采集—预处理—标注—验证”全流程规范化的极致样板——数据集不是堆文件,而是一套有学术与工程背书的标准化产品。 开源地址:https://github.com/PolymathicAI/the_well 把这六个例子放在一起看,一个”AI 可用”的数据集至少要满足五条:格式统一可机读、字段标准带元数据、许可清晰权责明、版本可溯能复现、规模适配场景需。回过头来对照,档案馆多年积累的著录体系和数字化成果,距离这样的数据集其实只差”语义化加工”这一步——这恰恰是最需要专业方法和技术投入的一步。 六、云典的实践与展望 在云典智能科技看来,档案高质量数据集建设是一项覆盖法规标准、数据治理、技术研发、平台搭建、场景落地的系统工程。我们的思路可以归纳为三句话: 场景先行。 先把应用目标钉死,再倒推数据边界和加工方式,坚决不做”为建而建”的数据集工程,让每一分加工投入都对准真实的模型训练需求。 盘活存量。 充分复用已有的档案数字化成果和存量数据库,在数字化阶段就同步考虑样本切分、语义标注、脱敏等后续需求,避免重复投入,让家底真正变成原料。 闭环运营。 把模型验证和交付运维纳入建设主线,用效果指标反哺数据迭代,让数据集成为可持续运营、可持续增值的数据产品,而不是交工即闲置的”一次性项目”。 档案是沉睡的资源,数据是流动的要素。把沉淀的历史资源转化为驱动人工智能发展的智慧动能,这条路才刚刚开始。云典智能科技愿意与档案界的各位同行一起,把这件事做扎实。 注:文中关于档案高质量数据集建设的理论框架,参考了《档案高质量数据集的建设路径》(《浙江档案》2026 年第 8 期)与徐拥军、成徐慧《建设面向人工智能的高质量档案数据集》(《中国档案》)等研究成果;开源数据集案例引自 GitHub / HuggingFace 公开项目。
武汉云典智能科技有限公司行业服务关键词:武汉档案整理、武汉档案公司、武汉档案整理公司、咸宁档案整理、咸宁档案公司、武汉档案数字化、咸宁档案数字化、湖北武汉档案整理、湖北武汉档案数字化、湖北武汉档案修复、咸宁档案修复、武汉档案、咸宁档案、湖北档案公司、湖北档案整理、武汉档案用品、咸宁档案用品、云典档案整理公司
|
 |
|
上一篇:人工智能+档案”相关依据 下一篇:【档案学习】大事记编撰指南 |

|